Hoe maak ik een goed semantisch model
Hoe maak ik een goed semantisch model
Dat is de vraag die velen zich stellen.
Wat is een semantisch model
Een semantisch model (in Power BI voorheen ook wel dataset genoemd) is de laag tussen je ruwe brondata en de rapporten en dashboards die gebruikers te zien krijgen. Het is een gestructureerde, business-vriendelijke weergave van je data: tabellen, relaties, berekeningen en definities worden hierin één keer goed vastgelegd, zodat iedereen in de organisatie dezelfde cijfers ziet en op dezelfde manier interpreteert.
Waarom is dat belangrijk?
- Eén bron van waarheid: definities zoals "omzet" of "actieve klant" liggen centraal vast, in plaats van dat elke rapportmaker zijn eigen versie bouwt.
- Herbruikbaarheid: meerdere rapporten en zelfs meerdere teams kunnen hetzelfde semantische model als basis gebruiken.
- Performance: door data te modelleren (bijvoorbeeld in een sterschema) en te comprimeren, kunnen rapporten sneller en efficiënter draaien dan wanneer direct op ruwe brontabellen wordt gerapporteerd.
- Begrijpelijkheid: technische veldnamen en complexe joins worden vertaald naar herkenbare begrippen voor de eindgebruiker.
Kortom: het semantische model is het fundament onder je rapportage. Een goed doordacht model bespaart je later veel tijd, discussie en herstelwerk.
Welke componenten zijn er
Een semantisch model bestaat uit een aantal bouwstenen die samen bepalen hoe krachtig, snel en onderhoudbaar het model is:
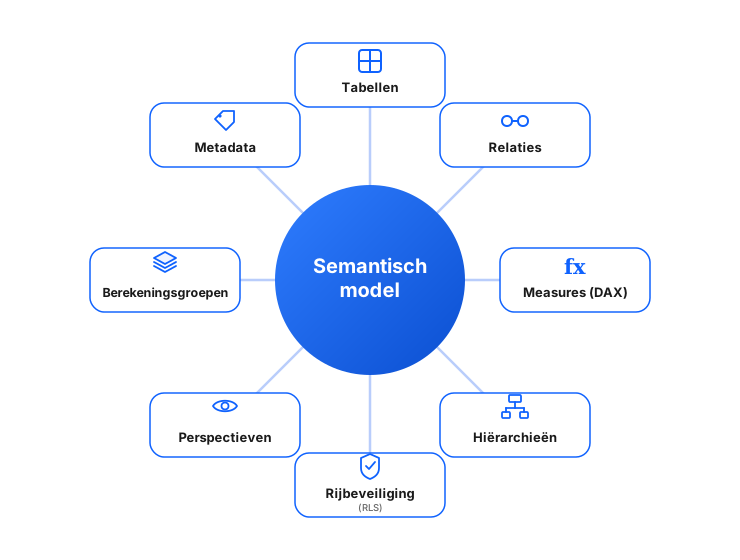
De belangrijkste bouwstenen van een semantisch model
- Tabellen: de feiten- en dimensietabellen die de basis vormen, idealiter opgezet volgens een sterschema (feitentabellen met metingen, dimensietabellen met beschrijvende kenmerken).
- Relaties: de verbindingen tussen tabellen, inclusief de kardinaliteit (1:n, 1:1) en de filterrichting, die bepalen hoe filters zich door het model verspreiden.
- Metingen (measures): berekeningen in DAX, zoals totalen, verhoudingen en tijdsintelligentie (bijvoorbeeld omzet, omzet vorig jaar, procentuele groei).
- Berekende kolommen en tabellen: afgeleide velden of tabellen die met DAX worden toegevoegd wanneer dit niet al in de brondata of het ETL-proces is opgelost.
- Hiërarchieën: logische groeperingen van kolommen, zoals Jaar > Kwartaal > Maand > Dag, waarmee gebruikers eenvoudig kunnen drillen.
- Rijbeveiliging (Row-Level Security): regels die bepalen welke gebruiker welke rijen data mag zien.
- Perspectieven: vereenvoudigde, gefilterde weergaven van een groot model voor specifieke doelgroepen of use-cases.
- Berekeningsgroepen (calculation groups): herbruikbare DAX-logica (bijvoorbeeld tijdsintelligentie) die op meerdere metingen tegelijk kan worden toegepast, zonder dat je die logica voor elke meting apart hoeft te dupliceren.
- Metadata: eigenschappen zoals opmaak, sorteervolgorde, synoniemen en beschrijvingen, die het model leesbaarder en beter doorzoekbaar maken (onder andere voor Q&A en Copilot).
Samen zorgen deze componenten ervoor dat een semantisch model niet alleen data bevat, maar ook de betekenis en logica erachter — vandaar de naam.